OKF 도입 가이드
에이전트가 지식 문서를 계속 고쳐 쓰기 시작하면 "이거 누가 썼고, 누가 확인했고, 언제까지 유효한가"가 매일의 문제가 됩니다. OKF(Open Knowledge Format)는 그 답을 별도 시스템이 아니라 파일 안에 적어두기로 한 포맷입니다. 마크다운 파일과 YAML 프론트매터, 그리고 디렉터리 하나가 전부입니다.
지식을 파일로 다루기로 하면
지식 코퍼스는 이제 한 번 쓰고 읽기만 하는 물건이 아닙니다. 에이전트가 계속 쓰고 계속 고칩니다. 대부분의 문서가 기계 생성물이 되는 순간, 평범한 마크다운 규약으로는 답할 수 없는 질문 다섯 개가 생깁니다.
| 질문 | OKF의 답 | 어디에 적히는가 |
|---|---|---|
| 무엇으로부터 만들어졌나 | 출처 | sources 목록과 항목별 신뢰 신호 |
| 얼마나 믿어도 되나 | 신뢰 | generated, verified에서 유도하는 트러스트 티어 |
| 아직 사실인가 | 신선도 | stale_after 절대 시각 |
| 이게 최신 버전인가 | 수명 | status: draft / stable / deprecated |
| 이 숫자는 정해진 방식으로 나왔나 | 증명 | Attested Computation과 attester |
이 다섯 가지를 런타임에서 해결하려면 매번 별도 시스템이 필요합니다. OKF의 선택은 프론트매터에 적어 두는 것입니다. 그래야 어떤 소비자든 파일만 읽고 같은 판단을 내릴 수 있습니다.
먼저 결론부터 놓겠습니다. 아래 다섯 줄이 OKF의 전부이고, 이후 내용은 이 다섯 줄을 실제로 운영할 때 필요한 세부 사항입니다.
- 포맷은 디렉터리 하나입니다.
.md파일들의 트리, 각 파일 맨 위에 YAML 프론트매터. 스키마 레지스트리도, 중앙 권한도, 필수 도구도 없습니다. - 필수 필드는
type하나뿐입니다.type만 있는 문서도 완전히 적합합니다. 나머지는 전부 선택입니다. - v0.2가 새로 정한 것은 신뢰입니다. 출처, 생성과 확인, 수명이 프론트매터로 올라왔습니다.
- 숫자에는 별도의 장치가 있습니다. Attested Computation은 "이 값이 승인된 계산식으로 나왔는가"를 사람 판단이 아니라 결정론적 코드로 확인하게 합니다.
- 소비자는 관대해야 합니다. 모르는
type, 모르는 키, 깨진 링크, 없는index.md를 이유로 번들을 거부하면 안 됩니다.
OKF는 무엇인가
OKF는 지식을 표현하는 포맷입니다. 여기서 지식이란 데이터와 시스템을 둘러싼 메타데이터, 맥락, 그리고 사람이 정리해 놓은 판단을 말합니다. 테이블 스키마 자체가 아니라 "이 테이블의 net_amount는 배송비를 뺀 금액이고, 재무팀은 반품 기간 30일이 지난 주문만 매출로 잡는다"는 쪽입니다.
포맷은 의도적으로 최소한입니다. UTF-8 마크다운 파일에 YAML 프론트매터를 붙이고, 디렉터리로 묶습니다. cat으로 읽을 수 있으면 OKF를 읽을 수 있고, git clone이 되면 OKF를 배포할 수 있습니다.
중립성이 핵심 주장입니다
OKF가 스스로 강조하는 성질은 "누구나 생산하고 누구나 소비한다"입니다. 특정 에이전트 프레임워크, 모델 제공자, 서빙 시스템에 묶이지 않습니다.

레퍼런스 에이전트와 시각화 도구가 저장소에 함께 들어 있지만, 그것들은 증명용 구현입니다. 기여의 본체는 포맷이고, 도구는 생산과 소비 양쪽에서 포맷이 실제로 돌아간다는 것을 보여주기 위해 존재합니다. 도입할 때 저 에이전트를 반드시 써야 하는 것은 아닙니다.
합의해 둘 용어
명세의 용어를 그대로 씁니다. 팀에 도입할 때 이것들만 먼저 맞춰두면 나머지 대화가 훨씬 짧아집니다.
| 용어 | 뜻 |
|---|---|
| Knowledge Bundle | 자기 완결적인 지식 문서 묶음이자 배포 단위. 디렉터리 하나가 번들 하나 |
| Concept | 번들 안의 지식 한 조각. 마크다운 문서 한 개 |
| Concept ID | 번들 루트 기준 파일 경로에서 .md를 뗀 것. 별도의 ID 체계가 없다 |
| Frontmatter | 파일 맨 위 ---로 감싼 YAML 블록. 질의하고 필터링할 대상 |
| Body | 프론트매터 뒤 전부. 사람과 LLM이 실제로 읽는 산문, 스키마, 예제 쿼리 |
| Source | 개념이 파생된 재료. 번들 바깥일 수도 안일 수도 있다 |
| Actor | 행위 주체 표기 규약. 에이전트는 <producer>/<version>, 사람은 human:<id>, 자동 프로세스는 process:<id> |
| Trust tier | verified에서 유도하는 신뢰 등급. 저장하는 값이 아니라 소비자가 계산하는 값 |
설계 원칙도 한 줄로 요약됩니다. OKF는 최소한으로만 의견을 갖습니다. 코퍼스가 스스로를 설명하는 데 꼭 필요한 구조적 규약만 표준화하고, 그 밖은 전부 생산자에게 맡깁니다. 개념 타입의 고정 분류 체계를 정하지 않고, 저장소나 서빙, 질의 인프라를 규정하지 않으며, Avro나 Protobuf 같은 도메인 스키마를 대체하려 들지도 않습니다.
번들 구조와 예약 파일
디렉터리 구조는 도메인 독립적입니다. 명세가 강제하는 계층이 없고, 생산자가 담고 싶은 지식에 맞게 나눕니다.
path/to/bundle/
  index.md                # 선택. 점진적 공개용 디렉터리 목록
  log.md                  # 선택. 변경 이력
  <concept>.md            # 번들 루트에 놓인 개념
  <subdirectory>/         # 하위 디렉터리로 개념을 묶는다
    index.md
    <concept>.md
배포 방법은 셋 중 하나입니다. git 저장소(이력과 작성자와 diff가 딸려오므로 권장), tarball이나 zip 아카이브, 또는 더 큰 저장소 안의 하위 디렉터리.
예약된 파일 이름은 index.md와 log.md 두 개뿐입니다. 이 둘은 계층 어디에서든 정해진 의미를 갖고 개념 문서 이름으로 쓸 수 없습니다. 나머지 모든 .md는 개념 문서입니다. 태그별 집계 파일 같은 것은 명세에 없습니다. 태그는 tags 프론트매터로 남고, 태그 브라우징 화면이 필요한 소비자는 소비 시점에 프론트매터를 훑어서 만들면 됩니다. 파일로 굳혀두면 금방 어긋나기 때문입니다.
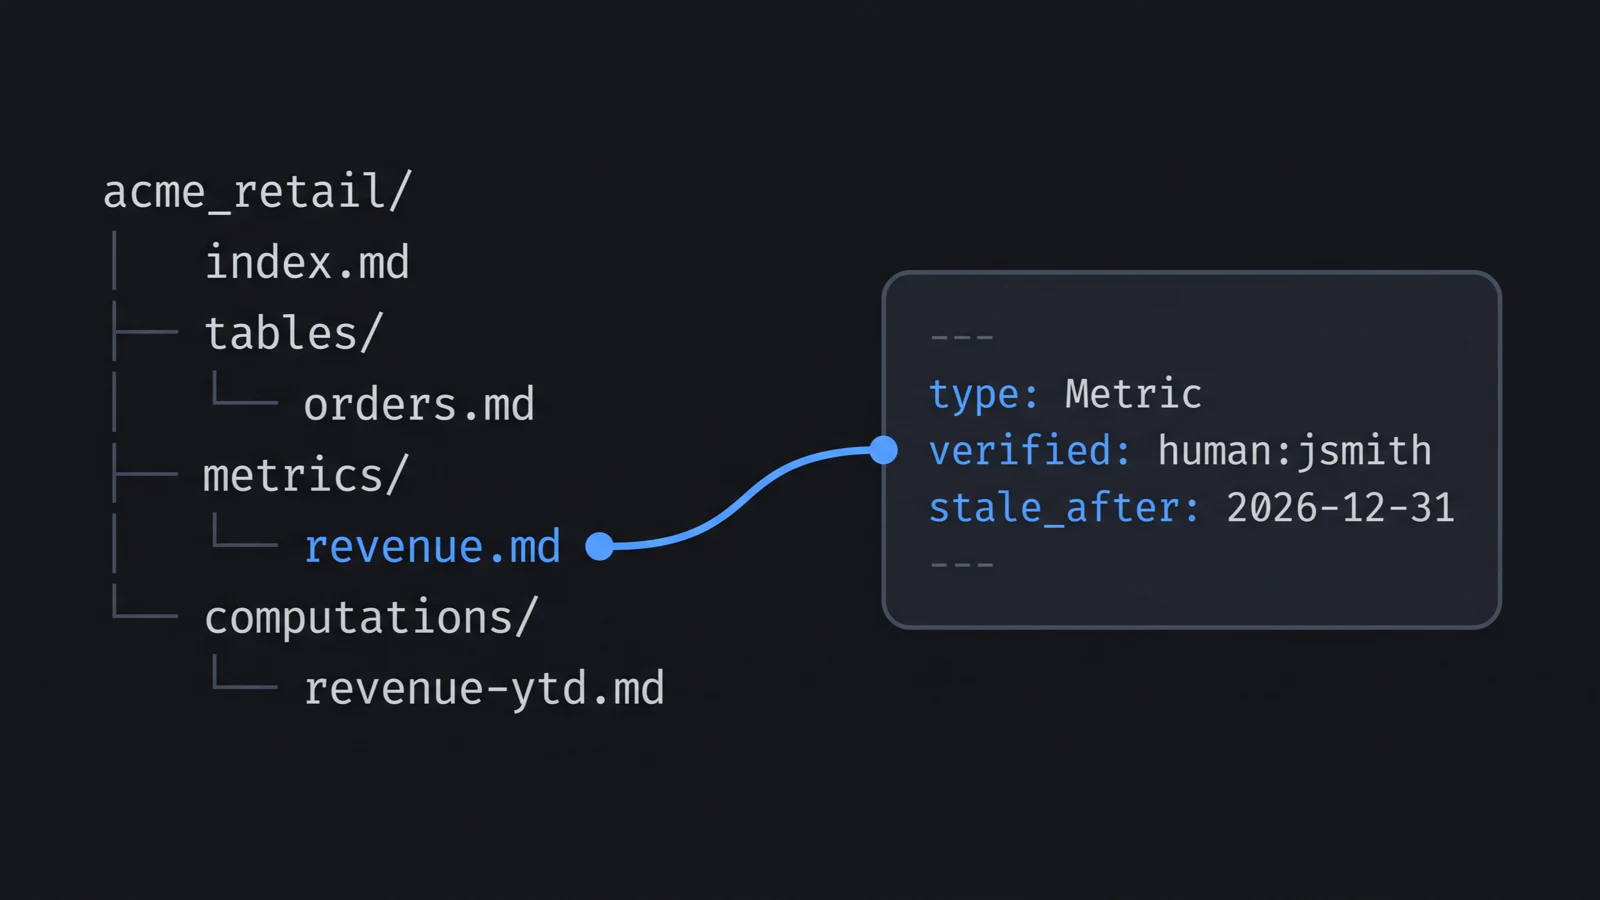
명세 저장소에 들어 있는 샘플 번들의 실제 구조입니다. 도메인 언어가 그대로 디렉터리가 되었습니다.
index.md
log.md
tables/orders.md                # 근거가 되는 BigQuery 테이블
metrics/revenue.md              # 지표의 비즈니스 정의
metrics/gross-margin.md
metrics/gross-margin-legacy.md  # status: deprecated
computations/revenue-ytd.md     # 승인된 SQL
policies/revenue-recognition.md # 재무 정책 원본
skills/run-on-bq.md             # executor 실행 지침
attesters/sql_equality.py       # 영수증 검증 코드
index.md는 컨텍스트 예산 장치입니다
index.md는 어느 디렉터리에나 놓일 수 있고 그 디렉터리의 내용을 나열합니다. 목적은 점진적 공개입니다. 사람이든 에이전트든 개별 문서를 열기 전에 무엇이 있는지 먼저 봅니다. 컨텍스트 예산이 유한한 LLM 소비자에게는 이것이 비용에 직결됩니다. 번들 전체를 컨텍스트에 밀어 넣는 대신 계층을 한 단계씩 내려갑니다.
# Subdirectories

* [tables](tables/index.md) - BigQuery tables the bundle grounds against.
* [metrics](metrics/index.md) - Business definitions of headline numbers.
* [computations](computations/index.md) - Sanctioned SQL.
* [policies](policies/index.md) - Source-of-truth Finance policies.
인덱스 파일에는 프론트매터가 없습니다. 예외가 하나 있는데, 번들 루트의 index.md만 okf_version 키를 가질 수 있습니다. 항목에는 링크된 개념의 description을 넣는 것이 좋습니다. 생산자가 자동 생성해도 되고, 없으면 소비자가 즉석에서 합성해도 됩니다.
log.md는 git 이력과 독자가 다릅니다
log.md는 계층 어느 수준에나 놓여 그 범위의 변경 이력을 기록합니다. 날짜로 묶인 평평한 목록이고 최신이 위입니다. 날짜 헤딩은 ISO 8601 YYYY-MM-DD 형태를 반드시 씁니다.
# Bundle history

## 2026-04-15
- **Deprecated** the legacy gross-margin definition. Original file moved
  to `metrics/gross-margin-legacy.md` with `status: deprecated`.

## 2026-02-10
- **Bundle bootstrapped** by `reference_agent/gemini-2.5-pro` from
  BigQuery `INFORMATION_SCHEMA`. Initial trust tier:
  machine-confirmed across the board.
git이 이미 커밋 이력을 갖고 있는데 왜 또 필요하냐는 질문이 나옵니다. 답은 독자가 다르다는 것입니다. git 이력은 파일 단위 diff이고, log.md는 "무엇이 왜 바뀌었는지"를 사람과 에이전트가 읽을 산문으로 요약한 것입니다. 위 예시의 마지막 항목처럼 초기 트러스트 티어 같은 판단은 diff에 남지 않습니다.
링크와 경로
개념끼리는 평범한 마크다운 링크로 이어집니다. 형태는 두 가지입니다.
- 절대(번들 상대).
/로 시작하고 번들 루트 기준으로 해석합니다. 문서를 하위 디렉터리 안에서 옮겨도 깨지지 않으므로 권장 형태입니다. 예:[customers](/tables/customers.md) - 상대. 표준 마크다운 상대 경로. 예:
[neighboring](./other.md)
링크에는 종류가 없습니다. A에서 B로 가는 링크는 관계가 있다는 것만 주장합니다. 부모 자식인지, 참조인지, 조인 관계인지는 주변 산문이 전달하지 링크 자체가 전달하지 않습니다. 그래프 뷰를 만드는 소비자는 보통 모든 링크를 타입 없는 방향 엣지로 취급합니다. 관계 종류를 기계적으로 구분해야 한다면 그건 프론트매터 확장 키로 직접 설계해야 합니다.
그리고 깨진 링크는 오류가 아닙니다. 소비자는 대상이 번들에 없는 링크를 허용해야 합니다. 그것은 아직 쓰이지 않은 지식을 나타낼 뿐입니다. 사내 CI에 링크 검사를 넣더라도 실패가 아니라 경고로 두는 것이 포맷의 의도에 맞습니다.
Concept 문서 해부
모든 개념은 UTF-8 마크다운 파일이고 두 부분으로 나뉩니다. ---로 감싼 YAML 프론트매터, 그리고 자유 형식 본문입니다.
---
type: <Type name>                  # 필수
title: <표시 이름>                  # 권장
description: <한 줄 요약>           # 권장
resource: <대상 자산의 정식 URI>    # 권장
tags: [<tag>, <tag>, ...]          # 선택
# 신뢰, 수명, 출처, 계산 계열
# 그 밖에 생산자가 정의한 임의의 키/값
---
type은 개념의 종류를 나타내는 짧은 문자열입니다. 소비자는 이 값으로 라우팅하고 필터링하고 화면을 고릅니다. BigQuery Table, API Endpoint, Metric, Playbook, Reference, Attested Computation 같은 값들이 예시로 나옵니다.
필수 본문 섹션은 없습니다. 다만 아래 헤딩은 관례적 의미를 가지므로 해당하면 쓰는 편이 좋습니다. 생산자는 산문보다 구조적 마크다운(헤딩, 목록, 표, 코드 펜스)을 선호해야 합니다. 사람의 독해와 에이전트의 검색 모두에 유리하기 때문입니다.
| 헤딩 | 용도 |
|---|---|
# Schema | 자산의 컬럼이나 필드에 대한 구조적 설명 |
# Examples | 구체적 사용 예. 보통 코드 펜스 |
# Computation | Attested Computation의 승인된 계산식 |
자산에 묶인 개념
---
type: BigQuery Table
title: Customer Orders
description: One row per completed customer order.
resource: https://console.cloud.google.com/bigquery?p=acme&d=sales&t=orders
tags: [sales, orders, revenue]
generated: { by: reference_agent/gemini-2.5-pro, at: 2026-05-28T14:30:00Z }
---

# Schema

| Column        | Type      | Description                       |
|---------------|-----------|-----------------------------------|
| `order_id`    | STRING    | Globally unique order identifier. |
| `customer_id` | STRING    | FK into [customers](/tables/customers.md). |
| `total_usd`   | NUMERIC   | Order total in US dollars.        |

# Joins

Joined with [customers](/tables/customers.md) on `customer_id`.
resource는 물리적 자산을 가리킬 때만 씁니다. 운영 절차나 업무 규칙처럼 실체가 없는 지식이면 그냥 뺍니다. 아래는 자산이 없는 개념입니다.
---
type: Playbook
title: "Incident response: data freshness alert"
description: Steps to triage a freshness alert on the orders pipeline.
tags: [oncall, incident]
generated: { by: human:ahormati, at: 2026-04-12T09:00:00Z }
---

# Trigger

A freshness alert fires when `orders` lags more than 30 minutes behind
its expected SLA. See the [orders table](/tables/orders.md).
확장은 자유입니다. 생산자는 추가 키를 마음대로 넣을 수 있고, 소비자는 모르는 키를 보존해야 하며(왕복 시 잃어버리면 안 됩니다) 그 때문에 문서를 거부해서도 안 됩니다.
출처: sources와 신뢰 신호
sources는 이 개념이 무엇으로부터 파생되었는지 기록합니다. 번들 바깥의 문서일 수도 있고, 같은 번들 안의 다른 개념일 수도 있습니다.
sources:
  - id: ga4-schema
    resource: https://developers.google.com/analytics/bigquery/export-schema
    title: GA4 BigQuery Export schema
    author: team:ga4-docs
    usage_count: 5000
    last_modified: 2026-05-30T00:00:00Z
usage_window: { from: 2026-06-01T00:00:00Z, to: 2026-06-30T00:00:00Z }
항목 안에서 필수는 resource 하나입니다. 소비자가 따라갈 수 있는 구체적 산출물(절대 URL, 번들 상대 경로)일 수도 있고, 따라갈 수 없는 범위 서술일 수도 있습니다. 예를 들어 all queries in BigQuery project X 같은 문자열도 유효한 resource입니다.
점수를 저장하지 않고 신호를 저장합니다
여기가 v0.2에서 가장 생각을 많이 한 지점입니다. OKF는 출처의 신뢰도 점수를 저장하지 않습니다. 점수는 주관적이고, 소비자 간에 이식되지 않으며, 금방 상합니다. 대신 객관적 사실만 항목별로 남기고 판단은 소비자에게 맡깁니다.
| 신호 | 성격 | 의미 |
|---|---|---|
author | 권위 | 이 출처를 만든 주체. 액터 표기법을 따른다 |
usage_count | 생존과 채택 | usage_window 기간 동안 실제로 사용된 횟수. 대시보드 조회, 쿼리 실행, 페이지 열람 |
last_modified | 최신성 | 출처 자체가 마지막으로 바뀐 시각. generated.at과 다르다 |
usage_window | 기준 구간 | sources의 형제로 한 번 쓰고 모든 usage_count의 기준이 된다 |
주장 단위 귀속은 각주로
본문의 특정 문장에 출처를 붙이려면 sources[].id를 라벨로 쓰는 마크다운 각주를 씁니다.
The `events_` table is sharded daily as `events_YYYYMMDD`.[^ga4-schema]

[^ga4-schema]: GA4 BigQuery Export schema
각주 라벨이 sources로 들어가는 조인 키입니다. 소비자는 각주의 산문을 파싱하는 대신 일치하는 항목을 찾아 귀속을 해석합니다. sources[0] 같은 위치 인덱스를 쓰지 않는 이유도 명시되어 있습니다. 에이전트가 이 문서들을 끊임없이 다시 씁니다. 목록 순서가 바뀌는 순간 위치 인덱스는 조용히 잘못된 출처를 가리키지만, 안정적인 id는 순서 변경을 견딥니다.
계보를 위한 전용 필드는 없습니다. resource가 다른 OKF 개념을 가리키면 파생 관계는 이미 번들 그래프의 엣지로 존재합니다. 소비자는 그 출처의 sources로 재귀해 들어가며 신뢰도를 전파시킬 수 있습니다. 명시적 derived_from이나 데이터 리니지 같은 더 깊은 계보는 v0.2 범위 밖입니다.
신뢰: generated, verified, 트러스트 티어
generated는 현재 내용이 어떻게 만들어졌는지를, verified는 그 내용을 누가 확인했는지를 기록합니다. 둘을 나눈 이유는 단순합니다. 쓴 주체와 확인한 주체가 같을 필요가 없기 때문입니다.
generated: { by: reference_agent/gemini-2.5-pro, at: 2026-06-20T22:53:05Z }
verified:
  - { by: human:ahormati, at: 2026-06-25T09:00:00Z }
  - { by: process:finance-nightly, at: 2026-06-26T02:00:00Z }
generated.by는 generated 안에서 필수이고, generated.at은 내용이 마지막으로 의미 있게 바뀐 시점을 표시합니다. verified는 검증 이벤트의 목록이고, 항목이 여러 개인 것은 독립적인 확인이 여러 번 있었다는 뜻입니다. 사람 승인과 야간 프로세스 확인이 함께 있는 식입니다. "얼마나 최근에"는 가장 늦은 at을 봅니다.
티어는 저장이 아니라 유도입니다
소비자는 verified에서 세 단계를 유도합니다.
| 티어 | 조건 |
|---|---|
unverified | verified 키가 아예 없음 |
machine-confirmed | human:이 아닌 액터만 확인함 |
human-reviewed | human:<id> 액터가 확인함 |
티어는 파일에 적히지 않고 소비자가 계산합니다. 그래서 소비자마다 게이팅 기준을 다르게 잡아도 포맷이 흔들리지 않습니다. 신뢰 프론트매터가 하나도 없는 개념도 여전히 소비 가능하고, 소비자는 그것을 거부하면 안 됩니다. 그리고 명세가 한 문장으로 못 박습니다. 트러스트 티어는 참고 신호이지 접근 제어가 아닙니다.
티어를 분류하는 기준이 human: 접두사이므로, 사람이 작성했거나 확인한 내용에는 생산자가 반드시 이 접두사를 써야 합니다. 액터 표기는 세 가지뿐입니다.
| 형태 | 대상 | 예시 |
|---|---|---|
<producer>/<version> | 에이전트와 도구 | reference_agent/gemini-2.5-pro |
human:<id> | 사람 | human:jsmith@acme |
process:<id> | 자동 프로세스 | process:finance-nightly |
사내 도입 시 이 규약을 가장 먼저 린터로 강제하는 것을 권합니다. 티어 계산 전체가 여기에 걸려 있습니다.
수명: status와 stale_after
status는 값이 셋뿐입니다.
| 값 | 의미 |
|---|---|
draft | 아직 리뷰되지 않음. 불완전할 수 있음 |
stable | 기본값. 소비할 준비가 됨 |
deprecated | 링크와 이력을 위해 남겨둠. 더 이상 현행이 아님 |
status가 없으면 stable로 봅니다. 실무에서 중요한 건 deprecated입니다. 파일을 지우면 그 파일을 가리키던 링크가 전부 끊기고, 왜 바뀌었는지가 사라집니다. 앞서 본 샘플 번들이 정확히 이 패턴을 씁니다. 낡은 총이익 정의를 metrics/gross-margin-legacy.md로 옮기고 status: deprecated를 달아 남겨둔 뒤, 새 정의를 metrics/gross-margin.md에 씁니다.
stale_after: 2026-09-23T00:00:00Z # 이 시각 이후로 내용은 낡은 것으로 본다
상대적 TTL이 아니라 절대 시각입니다. now >= stale_after이면 낡은 것입니다. 이렇게 정한 이유도 명세에 적혀 있습니다. 절대 시각이면 신선도 판정이 단순 비교 한 번으로 끝나고, 개념을 언제 읽었는지를 참조할 필요가 없습니다.
실무 감각으로는 정책 주기에 맞추는 것이 가장 자연스럽습니다. 샘플 번들의 매출 개념은 stale_after: 2026-12-31을 답니다. 재무팀이 매년 1월에 매출 인식 정책을 재발행하기 때문입니다. 2027년 1월 1일 이후에 이 개념을 소비하는 쪽은 새 정책 기준으로 정의를 다시 검증해야 합니다. 참고로 OKF의 모든 타임스탬프는 UTC 오프셋이 명시된 ISO 8601 날짜시각입니다.
Attested Computation: 숫자를 기계로 증명하기
sources가 "이 주장이 어디서 왔는가"에 답한다면, 이 개념은 "이 숫자가 우리가 정한 방식대로 나왔는가"에 답합니다. 실무에서 지식 베이스가 가장 크게 사고 치는 지점이 여기입니다.
Attested Computation 개념은 값의 의미만이 아니라 승인된 계산 방법을 함께 들고 있습니다. 그래야 소비자가 에이전트의 즉흥 SQL이 아니라 승인된 계산이 실제로 돌았음을 확인할 수 있습니다. OKF는 계산과 그것을 확인할 수단을 기록할 뿐, 아무것도 실행하지 않습니다.
| 필드 | 역할 |
|---|---|
runtime | 이 타입에서 필수. 계산을 어떻게 돌리는지, 따라서 파라미터가 무엇을 뜻하는지 정한다. bigquery, postgres, dbt, python 등 |
parameters | 에이전트가 채워도 되는 타입 있는 구멍의 목록. 각 항목은 { name, type, required } |
computation | 선택. 계산식을 담은 파일 경로. 있으면 본문 펜스 대신 이것을 쓴다 |
executor | 어떻게 실행하는가. resource가 실행 지침이나 코드를 가리키고, receipt가 실행이 반환해야 하는 필드를 선언한다 |
attester | 결정론적 검사. resource가 영수증을 받아 판정을 내는 코드를 가리킨다. LLM을 쓰지 않는다 |
---
type: Attested Computation
title: Revenue for a fiscal year
description: Sanctioned SQL that produces the recognized-revenue figure.
runtime: bigquery
parameters:
  - { name: year, type: integer, required: true }
executor:
  resource: skills/run-on-bq.md
  receipt: [job_id, executed_sql, result]
attester:
  resource: attesters/sql_equality.py
generated: { by: reference_agent/gemini-2.5-pro, at: 2026-06-30T14:00:00Z }
verified:
  - { by: human:jsmith@acme, at: 2026-07-01T09:00:00Z }
status: stable
stale_after: 2026-12-31T00:00:00Z
---
본문의 # Computation 아래에 승인된 계산식이 옵니다.
SELECT SUM(
    CASE WHEN o.currency = 'USD' THEN o.net_amount
         ELSE o.net_amount * fx.rate_to_usd END
  ) AS revenue_usd
FROM `acme.sales.orders` AS o
LEFT JOIN `acme.finance.fx_daily_rates` AS fx
  ON fx.currency = o.currency AND fx.rate_date = DATE(o.order_ts)
WHERE o.order_status = 'delivered'
  AND DATE_DIFF(CURRENT_DATE(), DATE(o.order_ts), DAY) >= 30
  AND EXTRACT(YEAR FROM o.order_ts) = @year
소비 흐름 여섯 단계

now >= stale_after이면 경고하거나 거부하고, 성공하면 작업 로그 링크처럼 판정을 눈에 보이게 노출합니다.에이전트가 할 수 있는 일에는 경계가 있습니다. 에이전트는 선언된 parameters에 값만 공급할 수 있고, 계산식을 작성하거나 편집해서는 안 됩니다. 계산식과 파라미터 값을 실행 가능한 산출물로 바인딩하는 것은 소비자의 몫이고, attester는 같은 바인딩을 독립적으로 다시 유도해 실제로 돈 것과 비교합니다. 비교 대상이 영수증에 담긴 전개된 산출물(executed_sql)이기 때문에 쿼리를 다시 썼거나, 계산 파일을 바꿔치기했거나, 의존물을 변형한 경우가 전부 걸립니다.
attester가 확인하는 것은 두 가지입니다. 출처는 실제로 돈 계산식이 승인된 계산식을 파라미터로 바인딩한 것과 같은지를 봅니다. 공백과 주석과 키워드 대소문자를 정규화한 뒤 비교하므로 테이블을 바꿨거나 필터를 추가했거나 조인을 뺀 경우가 걸립니다. 충실도는 화면에 표시하려는 값이 영수증의 권위 있는 값과 같은지를 봅니다. 에이전트가 텍스트로 뱉은 숫자를 믿지 않고 job id로 다시 읽습니다.
verified와 attestation은 다릅니다
이름이 비슷해서 자주 섞이는데, 완전히 다른 층위입니다.
| 확인하는 것 | 단위 | 번들 저장 | |
|---|---|---|---|
verified | 정의가 여전히 정책과 맞는가 | 문서 | 저장됨 |
| attestation | 이번 실행이 값을 승인된 방식으로 만들었는가 | 호출 | 저장되지 않음 |
정의가 낡았어도 어테스트는 깨끗하게 통과할 수 있고, 방금 검증한 정의라도 실행할 때마다 어테스트가 필요합니다. 그래서 둘 다 있어야 합니다.
적합성: 지켜야 할 것과 거부하면 안 되는 것
번들이 OKF v0.2에 적합하려면 세 가지만 만족하면 됩니다.
- 트리 안의 모든 비예약
.md파일이 파싱 가능한 YAML 프론트매터 블록을 갖는다. - 모든 프론트매터 블록이 비어 있지 않은
type필드를 갖는다. - 예약 파일명(
index.md,log.md)이 있다면 정해진 구조를 따른다.
반대로 소비자가 번들을 거부하면 안 되는 이유도 명시되어 있습니다. 선택 프론트매터 필드가 빠졌을 때, 모르는 type 값일 때, 모르는 추가 프론트매터 키가 있을 때, 상호 링크가 깨졌을 때, index.md가 없을 때. 다섯 가지 모두 거부 사유가 아닙니다. 소비자를 만든다면 이 목록을 그대로 테스트 케이스로 옮기면 됩니다.
번들은 루트 index.md의 프론트매터에 okf_version: "0.2"로 목표 버전을 선언할 수 있습니다. 선언된 버전을 모르는 소비자는 번들을 거부하는 대신 최선의 노력으로 소비를 시도해야 합니다.
v0.1에서 넘어온다면
v0.2는 v0.1을 대체하며 파괴적 변경이 두 가지 있습니다.
timestamp가generated.at으로 대체되었습니다. 소비자는generated가 없을 때 레거시timestamp로 폴백해도 됩니다.- 본문의
# Citations목록이sources로 대체되었습니다. 출처가 프론트매터로 올라왔습니다. 소비자는 v0.1 문서에 한해 레거시 목록을 계속 파싱해도 됩니다.
그 외는 전부 가산적입니다. 새 선택 키, 새 개념 타입 하나(Attested Computation), 새 관례 헤딩 하나(# Computation), 액터 표기 규약. 이것들이 없으면 그냥 v0.1 개념이 됩니다.
도입하면 무엇이 달라지는가
여기가 도입 검토의 본론입니다. 아래는 "마크다운 파일 + git"이라는 선택에서 자동으로 따라오는 것들이고, 서비스가 소유하는 메타데이터 저장소에서는 얻기 어려운 성질입니다.
지식 큐레이션이 평범한 소프트웨어 엔지니어링이 된다
번들이 git 안에 있으므로 PR, 줄 단위 diff, blame, 리뷰 워크플로가 그냥 동작합니다. 지표 정의를 바꾸는 일이 위키 페이지를 몰래 고치는 일이 아니라 리뷰어가 붙는 변경 요청이 됩니다. CODEOWNERS로 metrics/ 아래는 재무팀 승인을 강제하는 것도 새로 만들 필요 없이 됩니다. "이 지표 정의 누가 언제 바꿨죠?"의 답이 git blame입니다.
어댑터 없이 LLM 컨텍스트에 들어간다
독자와 내용 사이에 SDK도 질의 언어도 없습니다. 엔지니어는 개념을 cat하고, LLM은 파일을 그대로 컨텍스트에 넣습니다. 카탈로그 API를 호출해 JSON을 받아 프롬프트용 문자열로 다시 조립하는 계층이 통째로 사라집니다.
컨텍스트 비용이 구조적으로 내려간다
index.md가 계층마다 놓이므로 에이전트가 번들 전체를 적재하지 않고 한 단계씩 좁혀 들어갑니다. 점진적 공개가 포맷에 내장되어 있다는 뜻입니다. 개념 수가 수천 개로 늘어도 한 번의 질의가 읽는 토큰 수는 트리 깊이에 비례합니다. 전체 카탈로그를 임베딩해 top-k를 뽑는 방식과 비용 곡선이 다릅니다.
락인이 사라진다
번들은 디렉터리입니다. tarball로 보내거나, 아무 저장소에 올리거나, 아무 파일시스템에서 마운트하거나, 파일을 이해하는 아무 시스템에나 동기화하면 됩니다. 메타데이터와 나 사이에 독점 API가 없습니다. 카탈로그 제품을 갈아타도 지식은 남습니다.
"이 숫자 어디서 나왔냐"에 기계가 답한다
Attested Computation이 있으면 판단이 아니라 비교가 됩니다. 실행된 SQL을 정규화해 승인된 형태와 대조하고, 표시할 값을 job id로 다시 읽어 확인합니다. 에이전트가 그럴듯한 숫자를 지어내는 실패 모드가 표시 거부로 바뀝니다.
낡은 지식이 조용히 살아남지 못한다
stale_after는 단순 비교이므로 소비자가 예외 없이 적용합니다. status: deprecated는 파일을 지우지 않고도 "이제 아님"을 표시하므로 링크와 이력이 보존됩니다. 위키에서 가장 흔한 실패, 즉 3년 전 문서가 검색 상단에 계속 뜨는 문제가 포맷 차원에서 다뤄집니다.
기존 도구가 그대로 소비자가 된다
Notion, Obsidian, MkDocs, Hugo, Jekyll은 이미 마크다운과 YAML 프론트매터를 이해합니다. 커스텀 UI 없이 번들을 열람하고 편집하고 렌더링할 수 있습니다. ripgrep과 GitHub 코드 검색도 그대로 검색 도구가 됩니다. 사내 도입 초기에 별도 뷰어를 만들 필요가 없다는 뜻입니다.
그래프 모양이라는 점도 실무에서 큽니다. 개념끼리 평범한 마크다운 링크로 이어지므로 디렉터리 계층이 함축하는 부모 자식보다 풍부한 관계가 표현됩니다. 명세 저장소의 시각화 도구가 이 성질을 그대로 이용합니다. 링크 그래프의 역방향을 계산해 각 개념 아래에 "인용한 곳" 역링크 목록을 만들고, 힘 기반 그래프로 전체를 그립니다. 별도의 관계 저장소 없이 본문 링크만으로 나온 결과입니다.
도입 로드맵과 운영 규칙
명세는 조직 도입 절차를 규정하지 않습니다. 아래는 명세가 강제하는 것과 강제하지 않는 것을 구분해 정리한 실무 제안이며, 규범이 아니라 출발점입니다.
- 번들 하나를 만든다 (1일). 가장 논쟁이 많은 지표 세 개로 시작합니다. 매출, 활성 사용자, 이탈률처럼 회의 때마다 정의가 흔들리는 것들입니다. 디렉터리 하나,
metrics/아래 파일 세 개, 루트index.md하나면 됩니다.type외의 프론트매터는 아직 넣지 않습니다. 이 단계의 목적은 포맷 학습이 아니라 정의 합의가 실제로 어려운 지점을 드러내는 것입니다. - 최소 계약을 못 박는다 (1주). 명세가 열어둔 자리를 조직 규약으로 좁힙니다. 허용
type목록(초기에는 다섯 개 이하), 액터 표기(사람은human:접두사 필수, 사번인지 이메일인지 하나로 통일), 링크 형태(번들 상대 절대 경로를 기본으로),status정책(무엇이draft를 벗어나는 조건인가). 문서 한 장이면 충분합니다. - CI 린터를 붙인다 (2주). 적합성 조건 세 개는 30줄이면 검사됩니다. 여기에 2단계에서 정한 조직 규칙을 얹습니다.
- 소비자를 하나 붙인다 (1개월). 생산만 하고 소비하지 않는 지식 베이스는 반드시 썩습니다. 가장 싼 소비자부터 붙입니다. 사내 에이전트가 질문을 받으면 루트
index.md를 읽고 관련 디렉터리로 내려가 개념을 컨텍스트에 넣는 정도면 충분합니다. MkDocs로 정적 사이트를 띄우는 것도 같은 효과를 냅니다. - Attested Computation을 상위 다섯 개에만 (분기). 어테스트는 executor와 attester 코드가 필요하므로 비용이 있습니다. 처음부터 전면 적용하지 말고, 틀리면 대가가 큰 숫자에만 적용합니다. 재무 보고 지표, 과금에 쓰이는 수치, 외부에 공개되는 KPI 정도입니다.
3단계의 린터는 이 정도면 시작할 수 있습니다.
import sys, pathlib, yaml

ALLOWED = {"Metric", "BigQuery Table", "Playbook",
           "Reference", "Attested Computation"}
fails = []

for p in pathlib.Path("bundle").rglob("*.md"):
    if p.name in ("index.md", "log.md"):
        continue
    text = p.read_text(encoding="utf-8")
    if not text.startswith("---"):
        fails.append(f"{p}: 프론트매터 없음"); continue
    fm = yaml.safe_load(text.split("---", 2)[1]) or {}
    if not fm.get("type"):
        fails.append(f"{p}: type 없음")
    elif fm["type"] not in ALLOWED:
        fails.append(f"{p}: 허용되지 않은 type {fm['type']!r}")
    # 조직 규칙: 사람 작성 문서는 human: 접두사
    by = (fm.get("generated") or {}).get("by", "")
    if by.startswith("human") and not by.startswith("human:"):
        fails.append(f"{p}: 액터 표기 오류 {by!r}")

print("\n".join(fails) or "OK")
sys.exit(1 if fails else 0)
이 스크립트가 실패로 잡는 것은 명세의 적합성 조건과 조직 규약뿐입니다. 명세가 소비자에게 관대하라고 요구한 항목들(깨진 링크, 모르는 키)은 경고로만 두고 실패시키지 않습니다. 스타일이나 문장 품질은 리뷰어의 몫으로 남깁니다.
운영 규칙 네 가지
| 규칙 | 내용 |
|---|---|
| 소유권 | CODEOWNERS로 디렉터리별 승인자를 지정합니다. metrics/는 도메인 오너, computations/는 데이터 플랫폼과 도메인 공동 승인 |
| verified 승격 | 에이전트가 쓴 문서는 기본이 machine-confirmed입니다. 사람이 확인하면 verified에 human: 항목을 추가하는데, 이것을 PR 승인과 동시에 자동으로 넣는 액션을 두면 유지됩니다 |
| stale_after 기본값 | 정책 문서에 연동된 개념은 정책 재발행 주기에 맞추고, 나머지는 조직 기본값(예: 180일)을 생성 시점에 자동 부여합니다. 만료 임박 개념을 주간으로 리포트합니다 |
| 에이전트 쓰기 권한 | 에이전트는 브랜치에만 쓰게 하고 사람 승인 없이 기본 브랜치에 병합하지 않습니다. 계산식 파일(computations/, attesters/)은 에이전트 쓰기 금지 대상으로 둡니다 |
한계와 오해
도입 전에 알아야 할 것들입니다. 상당 부분은 명세가 스스로 "이후 개정으로 미룬다"고 밝힌 항목입니다.
명세가 아직 정하지 않은 것
- 런타임 프로토콜 전체. 영수증과 판정의 와이어 포맷, 실행을 둘러싼 어테스트 생명주기가 아직 없습니다. 지금 도입한다면 이 부분은 조직 내부 규약으로 직접 정의해야 하고, 나중에 명세가 확정되면 맞춰야 합니다.
- attester의 ABI, 이식성, 샌드박싱. 남의 번들에 딸려온 검증 코드를 어떻게 안전하게 실행할지가 미정입니다.
- 어테스트 캐싱. 같은 계산을 반복 호출할 때의 재사용 규칙이 없습니다.
- 시맨틱 레이어 템플릿. Looker나 dbt처럼 비교 대상이 SQL 동등성이 아니라 모델과 바인딩 동등성으로 바뀌는 경우가 아직 다뤄지지 않았습니다.
포맷의 구조적 한계
| 한계 | 대응 |
|---|---|
| 타입 레지스트리가 없다 | 자유는 좋지만 방치하면 타입이 난립합니다. 조직 내부 허용 목록을 린터로 강제해야 합니다 |
| 본문은 검증되지 않는 자유 텍스트 | 기계가 검증할 수 있는 것은 프론트매터뿐입니다. 본문 품질은 리뷰와 verified 승격 절차로만 담보됩니다 |
| 검색과 인덱싱이 없다 | 포맷의 비목표입니다. 검색은 별도로 붙여야 합니다. 다만 ripgrep과 GitHub 검색이 초기에는 충분히 쓸 만합니다 |
| 규모가 커지면 스캔 비용 | 개념이 수만 개가 되면 프론트매터 전수 스캔이 느려집니다. index.md를 성실히 유지하거나 별도 인덱스를 만들어야 합니다 |
| 접근 제어가 없다 | 트러스트 티어는 참고 신호이지 접근 제어가 아닙니다. 기밀 지식은 저장소 권한으로 분리하세요 |
자주 하는 오해
| 오해 | 실제 |
|---|---|
| RAG 파이프라인을 대체한다 | 아닙니다. OKF는 표현 포맷입니다. 검색과 청킹과 임베딩은 여전히 소비자 쪽 문제이고, OKF는 그 대상 문서를 더 신뢰할 수 있게 만들 뿐입니다 |
| 데이터 카탈로그를 대체한다 | 아닙니다. 명세는 Dataplex, Unity Catalog, Collibra 등에서 익스포트해 오는 것을 명시적으로 상정합니다. 카탈로그가 자산을 관리하고, OKF가 그 위의 맥락과 판단을 담습니다 |
| 도메인 스키마를 대체한다 | 아닙니다. Avro, Protobuf, OpenAPI를 참조하지 흡수하지 않습니다 |
| 레퍼런스 에이전트를 써야 한다 | 아닙니다. 증명용 구현입니다. 손으로 써도, 기존 파이프라인에서 뽑아도 똑같이 유효한 OKF입니다 |
| 모든 문서에 신뢰 필드를 채워야 한다 | 아닙니다. type만 있어도 완전히 적합합니다. 필드의 부재 자체가 의미를 갖습니다. 검증되지 않은 개념은 검증된 것과 구분될 뿐 거부되지 않습니다 |
마치며
도입 판단 기준은 한 줄로 정리됩니다. 지식을 사람이 가끔 고치는 조직이라면 위키로 충분합니다. OKF가 값을 하는 지점은 에이전트가 지식을 계속 쓰기 시작한 이후입니다. 그 순간부터 "누가 썼고 누가 확인했고 언제까지 유효한가"가 매일의 문제가 되고, 그 답을 파일 안에 두는 것이 가장 싸게 먹힙니다.
시작 비용도 낮습니다. 디렉터리 하나와 type만 있는 마크다운 파일 세 개로 오늘 시작할 수 있고, 신뢰 필드는 소비자가 붙은 뒤에 채워도 늦지 않습니다. 오히려 소비자가 트러스트 티어를 화면에 보여주기 시작해야 사람들이 verified를 채우려는 동기가 생깁니다. 생산부터 완벽하게 하려다 소비를 미루는 것이 이 종류의 프로젝트가 죽는 가장 흔한 방식입니다.
참고 자료
- GoogleCloudPlatform/open-knowledge-format (정식 저장소: 명세, 레퍼런스 에이전트, 샘플 번들)
- Open Knowledge Format v0.2 (SPEC.md) (이 글의 모든 규범적 서술의 출처)
- 샘플 번들 acme_retail (신뢰, 출처, 수명, 어테스트 계열을 모두 사용하는 예제)
이 글에서 도입 로드맵과 운영 규칙 부분은 명세가 규정하지 않는 영역에 대한 실무 제안이고, 그 외 규범적 서술은 v0.2 명세와 공개 샘플 번들을 근거로 합니다.